На этой странице
Выбор чанкинга
В разделе Конфигурация → Чанкинг выберите один чанкер для пространства.
Через API замените chunk в полной конфигурации пайплайна одним из
объектов ниже. Значения по умолчанию и допустимые диапазоны возвращает
GET /api/v1/pipeline/catalog. После изменения примените настройки
и перестройте корпус.
fixed — размер и перекрытие в токенах.
structural — сохранение разделов, пунктов, кода и таблиц.
semantic — границы по расстоянию между эмбеддингами.
hierarchical — поиск по короткому фрагменту с возвратом более широкого контекста.
late — эмбеддинги фрагментов с учётом контекста документа.
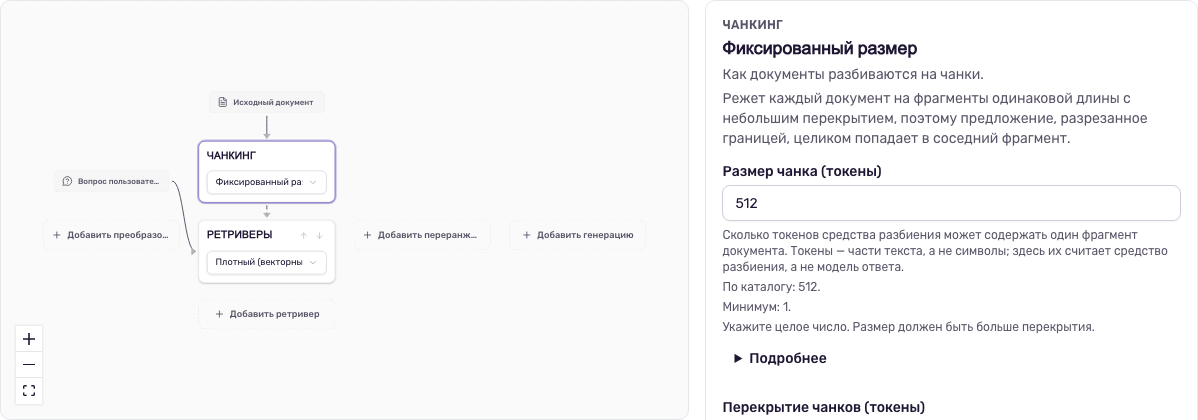
Выберите ноду на схеме, чтобы настроить размер фрагмента в токенах.
Фиксированный размер (fixed)
Задайте размер chunk_size и перекрытие chunk_overlap.
По умолчанию это 512 и 64 токена. Перекрытие должно быть меньше размера.
Оба значения указаны в токенах чанкера.
Первый фрагмент
Подайте заявку. Приложите маршрут.
Второй фрагмент
Приложите маршрут. Дождитесь согласования.
separator по умолчанию равен одному пробелу,
paragraph_separator — трём переводам строки. Пустая строка в
secondary_chunking_regex отключает запасное разбиение по частям предложения.
{"node":"fixed","params":{"chunk_size":384,"chunk_overlap":48}}
По структуре источника (structural)
Задайте chunk_size и chunk_overlap в токенах чанкера.
По умолчанию это 512 и 64. Перекрытие должно быть меньше размера, который
ограничивает исходный фрагмент и текст с добавленным контекстом.
Чанкер сохраняет диапазоны исходного текста, названия разделов и номера страниц, если они доступны. Крупные блоки он делит, а при неопределённой структуре режет документ как обычный текст. Для поиска можно добавить название документа и путь к разделу. Генерация резюме и пояснений к фрагментам недоступна.
{"node":"structural","params":{"chunk_size":512,"chunk_overlap":48,"context_section_path":true}}
По смене темы (semantic)
Задайте breakpoint_percentile — процентиль расстояний внутри документа,
выше которого чанкер ставит границу. По умолчанию 95, диапазон от 1 до 100.
buffer_size задаёт число соседних предложений с каждой стороны
при расчёте эмбеддинга. Значение по умолчанию и минимум — 1.
Эмбеддинги для разбиения рассчитывает модель пространства при индексации.
Длина фрагментов переменная.
{"node":"semantic","params":{"breakpoint_percentile":90,"buffer_size":1}}
Короткий фрагмент и широкий контекст (hierarchical)
Задайте chunk_sizes в токенах чанкера от крупного уровня к мелкому.
По умолчанию [512, 128]. Параметр chunk_overlap по умолчанию
равен 16, применяется на каждом уровне и должен быть меньше минимального
размера. Проверка конфигурации предупреждает о равных или растущих размерах.
Родительский фрагмент
К заявке нужно приложить маршрут. Согласование придёт по почте.
Фрагмент 1 в индексе
К заявке нужно приложить маршрут.
Фрагмент 2 в индексе
Согласование придёт по почте.
В поиске участвуют дочерние фрагменты. Если у найденного фрагмента есть
родитель, API может вернуть его текст в поле parent_text.
{"node":"hierarchical","params":{"chunk_sizes":[640,160],"chunk_overlap":24}}
Эмбеддинги в контексте документа (late)
Настройте плотный векторный поиск и поддерживаемую локальную модель с
усреднением состояний токенов, например nomic-ai/modernbert-embed-base,
если она установлена. Проверка отклоняет удалённые модели и несовместимые
способы агрегации, включая BAAI/bge-m3 из быстрого старта с CLS-токеном.
Задайте chunk_tokens и chunk_overlap_tokens в токенах модели.
По умолчанию это 512 и 64. Перекрытие должно быть меньше окна. Модель
читает длинный документ перекрывающимися проходами, а ContextBase
усредняет состояния токенов каждого фрагмента. Запрос кодируется
обычным способом. Параметры добавления контекста в этом режиме недоступны.
{"node":"late","params":{"chunk_tokens":512,"chunk_overlap_tokens":64}}
Контекст для поиска
Проверьте embedding_text на странице фрагмента или в ответе API.
Это текст для эмбеддинга. Поиск по-прежнему возвращает исходный фрагмент.
Добавление контекста по умолчанию выключено.
context_document_titleдобавляет название документа.context_section_pathдобавляет путь по заголовкам. Фиксированный, семантический и иерархический режимы учитывают заголовки Markdown вне блоков кода. Структурный также использует собранное оглавление.context_in_lexicalпередаёт тот же контекст в совместимые полнотекстовые и разрежённые индексы.context_document_summaryвызывает LLM один раз на документ, если сохранённое резюме нельзя использовать повторно. Лимиты по умолчанию — 8192 символа на входе и 160 токенов на выходе. Параметрыsummary_*задают инструкцию, модель, адрес API и температуру. При ошибке или пустом ответе документ может проиндексироваться без резюме.context_fragment_explanationвызывает LLM для каждого фрагмента, используя текст его раздела. Лимиты по умолчанию — 12000 символов на входе и 256 токенов на выходе. Параметрыfragment_*задают инструкцию и переопределения модели. При совпадении источника и настроек можно использовать сохранённые пояснения. Ошибка вызова прерывает обработку.
Для генерации контекста нужна доступная LLM. Провайдер может тарифицировать эти вызовы. После изменения настроек перестройте индекс и повторите те же запросы для сравнения.
Измерьте сохранённые фрагменты
После индексации откройте Конфигурация → Сколько вмещает фрагмент
или вызовите GET /api/v1/spaces/{space_id}/chunks/sizes с правом чтения.
Для каждой нарезки отчёт показывает число фрагментов, бюджет при его
наличии, медиану и средний размер. Сравнивайте токены в одной единице.
Если токены подсчитаны лишь для части фрагментов, проверьте размер выборки.
Для позднего чанкинга отчёт показывает бюджет и фактический размер в символах.
Отчёт о размерах фрагментов