На этой странице
Обработка и индексация
Загрузите первый документ
Откройте пространство, где вы редактор или владелец. В разделе Документы нажмите Выбрать файлы и загрузите текст или Markdown в UTF-8. Для PDF, офисных файлов или сканов сначала настройте Extractor.
Дождитесь статуса Проиндексирован и проверьте, что документ активен. Найдите фразу из файла и откройте совпавший фрагмент.
Если фразы нет, проверьте фрагменты. Прежде чем менять настройки поиска, проверьте извлечённый текст и границы фрагментов.
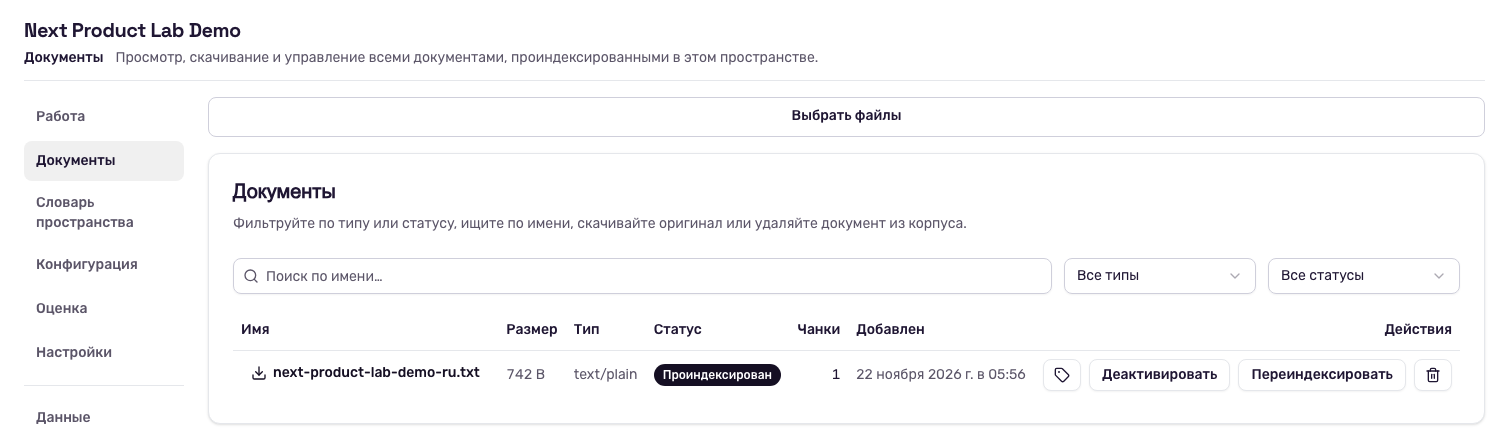
Проверьте Статус и число фрагментов в столбце Чанки.
Что попадает в индекс
Исходный файл
ContextBase сохраняет файл для скачивания и повторной обработки.
Извлечение
Экстрактор читает текст и доступную структуру, например разделы и таблицы.
Чанкинг
Чанкер делит извлечённый текст на фрагменты.
Индексация
Пространство строит представления, по которым работают его ретриверы.
Загрузка и поиск через REST
Укажите URL установки в BASE_URL и UUID пространства в SPACE_ID.
Задайте CONTEXTBASE_API_KEY в доверенном клиенте или сервисе. Для загрузки
ключу нужно право записи, для второго запроса — право поиска.
printf '%s\n' 'Заявку на командировку подают за десять рабочих дней до выезда.' > travel.txt
curl --fail-with-body -sS \
  -H "X-API-Key: ${CONTEXTBASE_API_KEY}" \
  -F 'file=@travel.txt;type=text/plain' \
  -F 'name=Правила командировок' \
  -F 'metadata={"department":"operations","year":2026}' \
  "${BASE_URL}/api/v1/spaces/${SPACE_ID}/documents"
Документ обрабатывается в рамках запроса. В ответе 201 Created
проверьте status и is_active, а id сохраните для просмотра
или скачивания. Если name не указан, используется имя файла.
Передавайте metadata одним объектом JSON с исходными типами значений.
Например, число 2026 и строка "2026" различаются.
Загрузка через API
Выполните поиск в том же пространстве.
curl --fail-with-body -sS \
  -H "X-API-Key: ${CONTEXTBASE_API_KEY}" \
  -H 'Content-Type: application/json' \
  -d '{"query":"Когда надо подать заявку на командировку?","top_k":3}' \
  "${BASE_URL}/api/v1/spaces/${SPACE_ID}/search"
Импортируйте архив
В разделе Документы пространства с управляемым хранилищем выберите режим импорта архива ZIP, TAR.GZ, TGZ, RAR или 7Z:
Одним документом объединяет извлечённый текст читаемых файлов.
Отдельными документами создаёт собственную запись и операцию индексации для каждого принятого файла. Проверьте результаты по отдельности, часть файлов может быть пропущена или обработана с ошибкой.
В управляемом пространстве используйте REST-эндпоинт
POST /api/v1/spaces/{space_id}/documents/archive. Передайте архив в
multipart-поле file, а в строке запроса задайте UUID command_id и
mode=combined или mode=separate. Ответ 202 Accepted содержит
items со статусами элементов и идентификаторами операций для наблюдения.
Если ответ на запрос не пришёл, повторите импорт с тем же UUID команды,
файлом, режимом и остальными параметрами. Чтение архива ограничено числом
элементов и объёмом после распаковки. Пути внутри архива проверяются, а лимит
загрузки применяется к самому архиву. Для подключённого хранилища браузер
загружает архив целиком через обычный импорт с правилами записи этого
хранилища.
Импорт архива
Что проверить при загрузке
400: проверьте указанное поле, тип метаданных или настройки извлечения.403: проверьте, что у вас есть права редактора или владельца.413: проверьтеDOCUMENT_MAX_UPLOAD_BYTES(100 МиБ по умолчанию) и ограничение шлюза на размер запроса. Лимит загрузки.409или428для подключённого хранилища: прочитайте причину и проверьте сопоставление полей, совместимые настройки и подтверждение корпуса по руководству Подключения и хранилища.Загружен (
uploaded): файл сохранён. Если фрагменты недоступны в поиске, проверьте кодировку, поддержку формата и OCR.